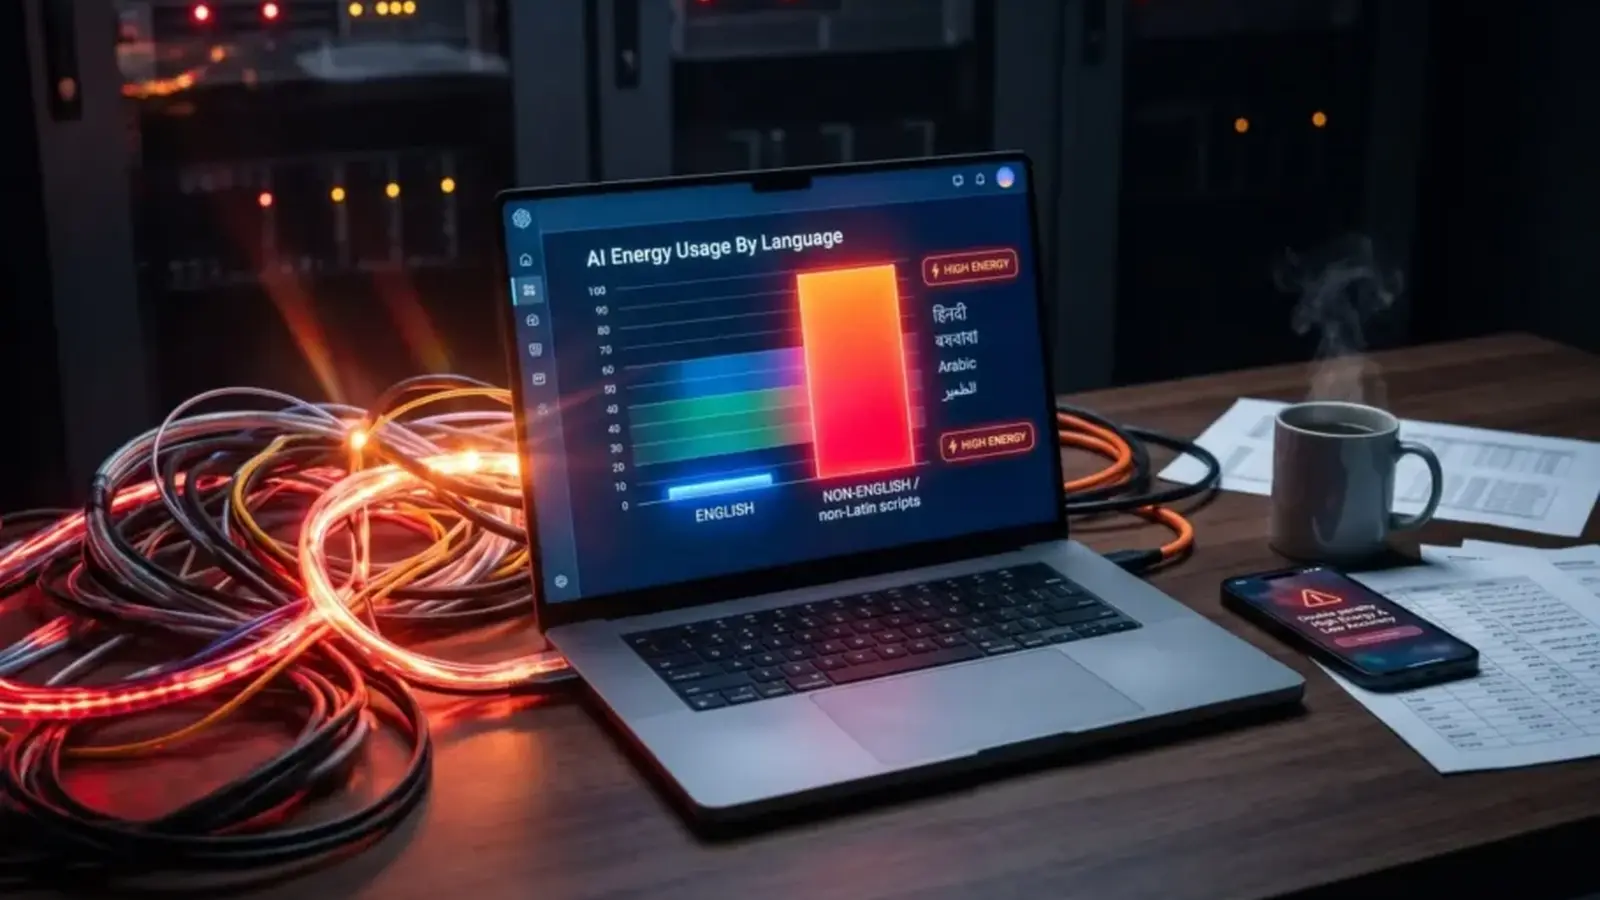
Naujame Mičigano universiteto tyrime nustatyta, kad generatyviniai DI modeliai, generuodami tekstą kitomis nei anglų kalbomis, sunaudoja gerokai daugiau energijos – nuo 1,4 iki 180 kartų daugiau. Be to, rezultatai šiomis kalbomis gali būti ne tokie tikslūs. Tyrėjai teigia, kad generuodami tekstą ne anglų kalba DI modeliai sunaudoja nuo 1,4 iki 180 kartų daugiau energijos.
Tyrimo rezultatai ir apimtis
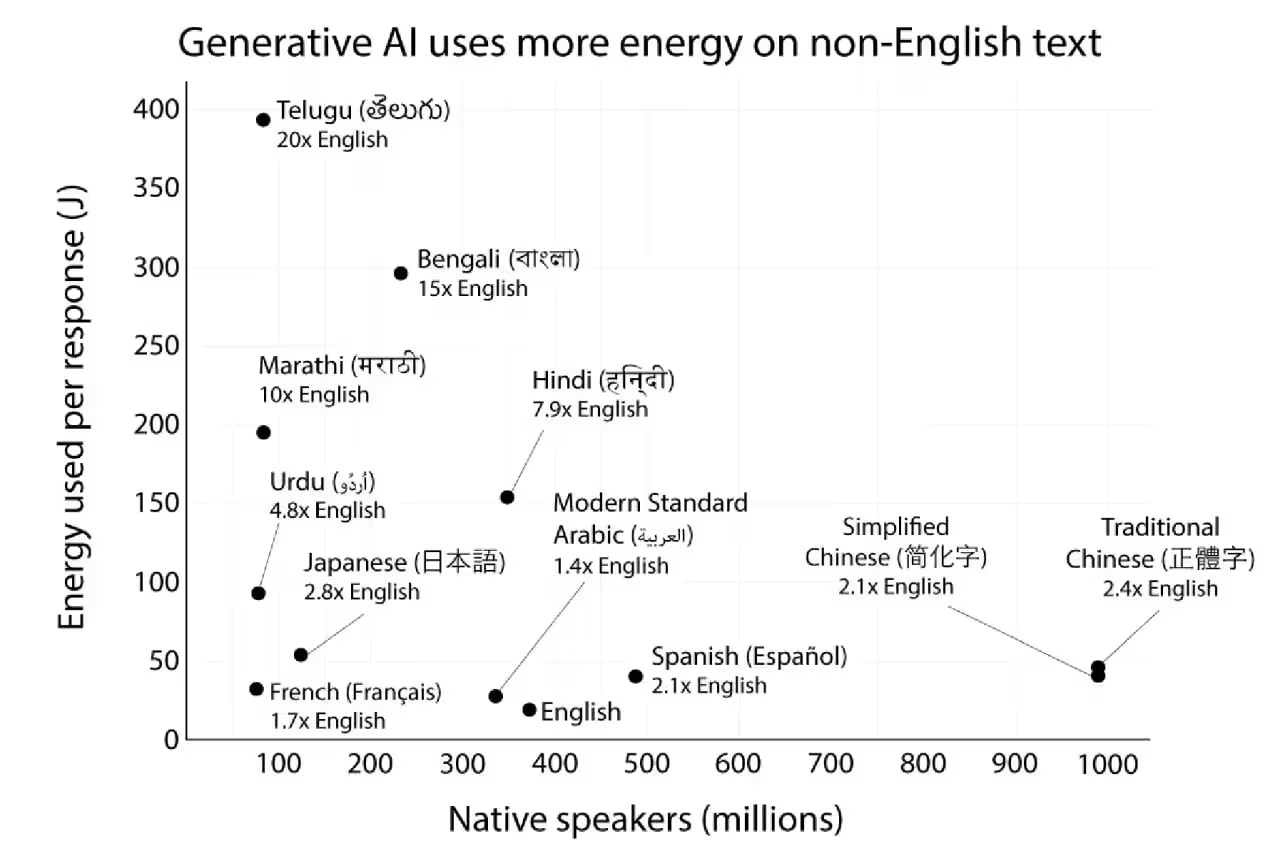
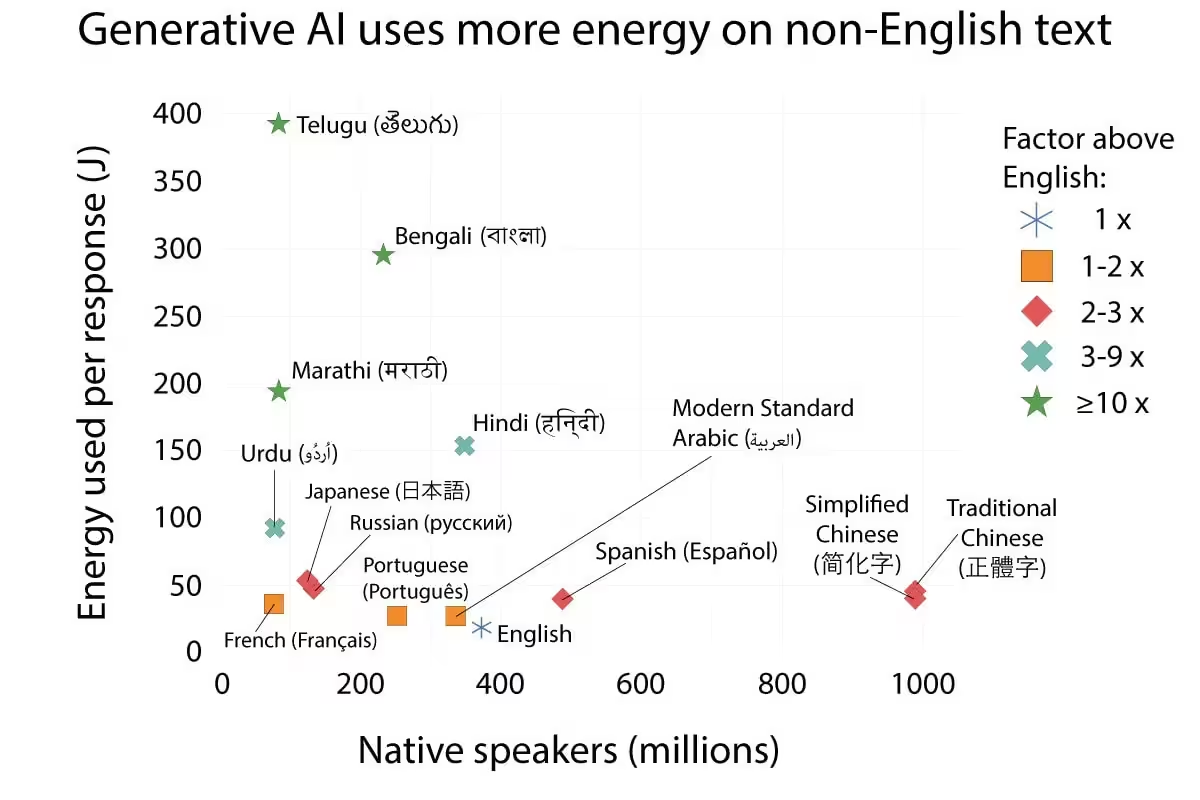
EMNLP konferencijoje pristatytame tyrime buvo matuojamas energijos suvartojimas generuojant tekstą įvairiomis kalbomis. Didžiausi skirtumai nustatyti kalbose, kurios nenaudoja lotyniškojo alfabeto ir turi mažiau skaitmeninių mokymo duomenų. Vidutiniškai modeliams tekstui ne anglų kalba generuoti reikia nuo 1,4 iki 180 kartų daugiau energijos nei tekstui anglų kalba. Vakarų Europos kalboms jos dažniausiai reikėjo maždaug dukart daugiau nei anglų kalbai, o hindi ir bengalų kalboms – atitinkamai 7,9 ir 15,3 karto daugiau. Autoriai apskaičiavo, kad maždaug 5,2 mlrd. žmonių pasaulyje, generuodami tekstą gimtąja kalba, sunaudoja daugiau nei dukart daugiau energijos nei anglų kalbos vartotojai.
Naihao Dengas, Mičigano universiteto informatikos ir inžinerijos doktorantas bei pirmasis straipsnio autorius, teigia, kad kalboms, kurioms reikia daugiau energijos, būdingas ir mažesnis modelių tikslumas. Jis šį poveikį pavadino „dviguba bauda“, kuri dėl didesnių sąnaudų gali riboti vartotojų prieigą ir mažinti įmonių paskatas palaikyti kai kurias kalbas.
Metodai, modeliai ir matavimai
Siekdama įvertinti skirtumus, komanda išbandė tris atvirus modelius, o energijos suvartojimą matavo specialia sistema. Buvo testuojami šie modeliai:
- Qwen 3 (Alibaba)
- Gemma 3 (Google)
- Llama 3.1 (Meta)
Tyrėjai naudojo „Belebele“ duomenų rinkinį, skirtą modelių teksto suvokimui vertinti 122 kalbomis, ir ML.Energy matavimo sistemą. Jie pateikė klausimus su keliais atsakymų variantais, matematikos uždavinius ir laisvos formos tekstines užklausas. Rezultatai parodė, kad visi trys modeliai, apdorodami angliškas užklausas, vidutiniškai sunaudojo mažiau energijos. Skirtumai išliko ir naudojant didesnius modelius bei skirtingus procesorius.
Priežastys ir techninis paaiškinimas
Pagrindinė techninė priežastis – žetonizavimas. Žetonai yra pagrindiniai duomenų vienetai, kuriuos apdoroja modeliai, todėl prieš atliekant skaičiavimus tekstas suskaidomas į žetonus. Tokiose kalbose kaip hindi ir nepalų, kurių simboliai keičia formą arba jungiasi su diakritiniais ženklais, tam pačiam semantiniam turiniui išreikšti sukuriama gerokai daugiau žetonų. Didesnis žetonų skaičius didina atminties naudojimą, todėl modeliai priversti juos apdoroti mažesnėmis grupėmis. Dėl to vienam žetonui sunaudojama daugiau energijos ir mažėja apdorojimo sparta. Kadangi daugelis paslaugų teikėjų už prieigą skaičiuoja pagal žetonų kiekį, ne anglų kalbų vartotojai taip pat gali patirti didesnes tiesiogines išlaidas.
Pasekmės ir siūlomos priemonės
Tyrimas atskleidžia galimą pasaulinės skaitmeninės nelygybės šaltinį: daugelio nelotyniškų ir mažesnių išteklių kalbų vartotojai gali daugiau mokėti už energiją ir paslaugas, tačiau gauti prastesnės kokybės rezultatus. Siekdami sumažinti šį disbalansą, tyrėjai rekomenduoja DI bendrovėms optimizuoti paslaugas platesniam kalbų spektrui, pavyzdžiui, nukreipti užklausas į konkrečioms kalboms pritaikytus modelius arba, kai tikslinga, prieš apdorojimą išversti užklausas į anglų kalbą.

„Technologijos visada mane žavėjo – nuo išmaniųjų telefonų iki dirbtinio intelekto proveržių. Džiaugiuosi galėdama dalintis naujienomis su jumis kiekvieną dieną.“
Diskusija
Palikti komentarą
Komentarai
Komentarų dar nėra. Būkite pirmas.